伝播ノイズ吸収(PNA)による期待値の改善#
使用量の目安: Heron プロセッサで 10 分(注意: これはあくまで目安です。実際の実行時間は異なる場合があります。)
学習成果#
伝播ノイズ吸収(PNA)とは何か、また、学習した逆ノイズチャネルを測定する観測量に吸収させることで 2 量子ビット・ゲートのノイズをどのように緩和するか
samplomaticを使って、ツワーリング、基底変換、ノイズ注入のために回路の層をボックス化し、アノテーションを付ける方法[NoiseLearnerV3](/docs/guides/directed-execution-model#noiselearnerv3) で層のノイズを学習し、qiskit-addon-pnaを使ってノイズを緩和する観測量へ伝播させる方法qiskit-ibm-runtimeのQuantumProgramクラスとExecutorクラスを使ってランダム化した回路をサンプリングし、PNA を TREX およびポストセレクションと組み合わせる方法
前提知識#
Qiskit パターン のワークフロー
観測量の期待値を計算するための Estimator プリミティブの使い方
Estimator プリミティブでのエラー緩和オプションの組み合わせ で扱っている、パウリ・ツワーリングや TREX などのエラー緩和手法
背景#
このチュートリアルでは、Qiskit の高度なエラー緩和ツールを活用して、ノイズを含む量子実験における期待値の推定を改善する方法を示します。
伝播ノイズ吸収(PNA)とは#
伝播ノイズ吸収は、2 量子ビット・ゲートに影響する逆ノイズチャネルを通して観測量を伝播させ、ノイズを緩和する観測量を得ることで、ゲート・エラーを緩和する手法です。
量子エラー緩和を使えば、完全なフォールト・トレランスを必要とせずに、ノイズを含む量子ハードウェアから有用な期待値を引き出すことができます。PNA は特に、回路の操作を変更するのではなく、ノイズの影響を観測量そのものに吸収させることに焦点を当てています。
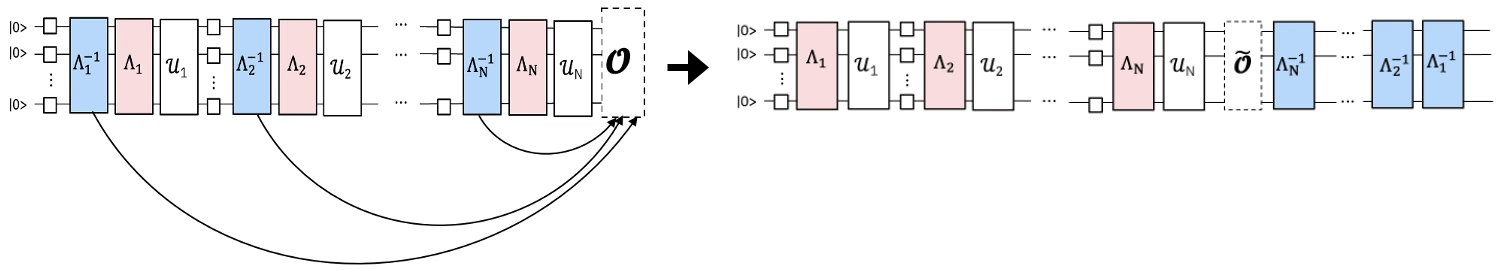
量子回路内のノイズを含む各ゲートは、理想的なゲートの後にノイズチャネルが続くものとしてモデル化できます。PNA はこれらのノイズチャネルを学習(特性評価)し、その逆を定義します。逆演算をハードウェアでの実行に挿入する(これは通常は実行不可能です)代わりに、PNA は逆ノイズチャネルを回路の前方へ伝播させ、観測量に適用します。このプロセスによって観測量 \(O\) は新しい演算子 \(\tilde{O}\) に変換され、ノイズを含む回路で \(\tilde{O}\) を測定すると、ノイズのない理想的な回路で \(O\) を測定した場合と同じ期待値が得られます。
これは次のようにまとめられます。
ノイズを含む各ゲート \(u_i\) を、理想的な演算の後にノイズチャネル \(\Lambda_i\) が続くものとしてモデル化する。
ノイズ特性評価のツールを使って、各 \(\Lambda_i\) を学習または推定する。
逆ノイズ写像 \(\Lambda_i^{-1}\) を定義し、パウリ転送の手法を使って回路の前方へ伝播させる。
これらの逆写像を観測量に吸収させ、ノイズを緩和した演算子 \(\tilde{O}\) を得る。
ノイズがパウリ・チャネル(より一般的にはスパース・パウリ・リンドブラッド・チャネル)として記述される場合、この伝播はパウリ伝播を使って効率よく実行できます。パウリ伝播は、逆ノイズチャネルがクリフォード演算と非クリフォード演算の層を通過する際にどのように変換されるかを、計算量を制御しながら近似するためのフレームワークを提供します。
緩和を観測量の側に移すことで、PNA は、物理的な補正操作を回路に挿入した場合に生じる大きなサンプリング・オーバーヘッドを回避します。その代わりに、元のノイズを含む回路を実行し、観測量を新しい演算子 \(\tilde{O}\) に変換します。\(\tilde{O}\) の期待値は、ノイズの影響を打ち消します。
PNA のワークフロー#
このプロセスは、次の概念的な段階を通して理解できます。最初の模式図は、標準的なノイズを含む実験を示しています。
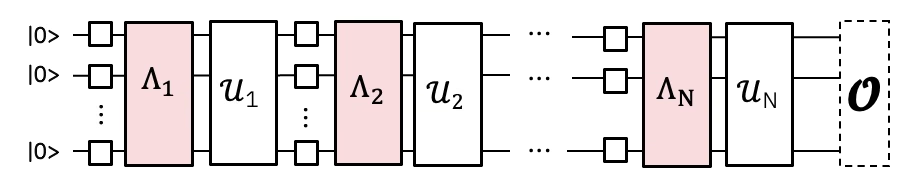
ノイズモデルを学習すれば、その逆を適用してノイズを打ち消すことができます。
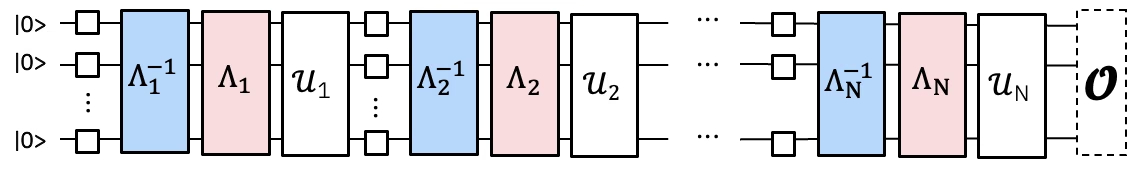
確率的エラー・キャンセレーション(PEC)のように逆ノイズチャネルを QPU 上でサンプリングして実装する代わりに、パウリ伝播を使って、測定する観測量に逆ノイズチャネルを古典的に適用します。得られた観測量を測定すると、学習したゲート・ノイズが実質的に緩和されます。
Samplomatic と Executor によるモジュール化されたエラー緩和#
PNA の手法は、Qiskit のモジュール化されたエラー緩和アーキテクチャーの上に構築されています。このアーキテクチャーは、samplomatic ライブラリーと、QuantumProgram クラスおよび Executor クラス(qiskit-ibm-runtime v0.47.0 で Qiskit Runtime に追加)を組み合わせて使い、伝播ノイズ吸収やパウリ・ツワーリングなどの手法を、さまざまな実験間で組み合わせたり再利用したりできるようにします。
緩和のロジックを回路の定義そのものに組み込むのではなく、緩和は samplomatic のアノテーションによって宣言的に表現され、Executor によってプログラム的に管理されます。Executor は、ランダム化した回路の生成、実行、後処理の方法を制御します。
このチュートリアルでは、Qiskit パターン を実装して、PNA が逆パウリ・ノイズチャネルを伝播させ、それに応じて観測量を変更することで、ノイズを含む QPU 上での期待値の推定を改善できることを示します。
ワークフローの概要#
ステップ 1: 量子問題へマッピングする
ミラーリングしたトロッター化キックド・イジング・モデルと、対象の観測量を構成します。
ステップ 2: ノイズの特性評価と伝播を行う
samplomaticを使って、回路内の固有の 2 量子ビット層と測定を特定し、アノテーションを付けます。NoiseLearnerV3を使って、固有の各層に影響するノイズを学習します。各
InjectNoiseアノテーションを、対応する学習済みノイズモデルに対応付けます。qiskit-addon-pnaを使って、逆ノイズチャネルを回路の前方へ伝播させ、対象の観測量に吸収させます。
ステップ 3: 量子実験を実行する
samplexによるランダム化サンプリングを指定するQuantumProgramを定義し、Executorを使ってバックエンド上で実験を実行します。
ステップ 4: 結果を再構成して分析する
緩和戦略(PNA、PNA+TREX、PNA+PS、PNA+PS+TREX)を比較し、緩和なしの結果に対する改善を可視化します。
要件#
このチュートリアルを始める前に、次のものがインストールされていることを確認してください。
Qiskit SDK v2.2 以降(可視化 サポート付き)
Qiskit Runtime v0.47 以降(
pip install qiskit-ibm-runtime)Samplomatic v0.13 以降(
pip install samplomatic)PNA Qiskit アドオン(
pip install qiskit-addon-pna)Qiskit アドオンユーティリティ(
pip install qiskit-addon-utils)
セットアップ#
from qiskit import QuantumCircuit
from qiskit.quantum_info import Pauli, SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager, PassManager
from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    QuantumProgram,
    Executor,
    NoiseLearnerV3,
)
from qiskit_addon_utils.exp_vals.measurement_bases import (
    get_measurement_bases,
)
from qiskit_addon_utils.exp_vals.expectation_values import (
    executor_expectation_values,
)
from qiskit_addon_utils.noise_management import trex_factors
from qiskit_addon_utils.noise_management.post_selection import PostSelector
from qiskit_addon_utils.noise_management.post_selection.transpiler.passes import (
    AddPostSelectionMeasures,
    AddSpectatorMeasures,
)
from qiskit_addon_pna import generate_noise_mitigating_observable
import samplomatic
from samplomatic.transpiler import generate_boxing_pass_manager
from samplomatic.annotations import InjectNoise
from samplomatic.utils import get_annotation, find_unique_box_instructions
import numpy as np
import matplotlib.pyplot as plt


# 対象のバックエンド上で、エラーの小さい量子ビットの連結した鎖を選択する。
# ミラーリングしたキックド・イジング回路は 1 次元の鎖なので、連結した物理量子ビットの
# 直線があれば十分である。このヘルパーはバックエンドのカップリングマップをたどり、
# エラーが最も小さい 2 量子ビットのエッジに沿って鎖を伸ばすため、ハードコードされた
# レイアウトに頼らず、どのバックエンドでも動作する。
def find_qubit_chain(backend, length):
    """``backend`` 上で ``length`` 個の物理量子ビットからなる連結した鎖を見つける。

    鎖はエラーが最も小さい 2 量子ビットのエッジに沿って貪欲に伸ばされるため、
    性能の良い量子ビットが優先される。ミラーリングしたキックド・イジング回路は
    1 次元の鎖なので、連結した直線があれば十分である。
    """
    target = backend.target

    # ネイティブな 2 量子ビット・ゲートを特定し、エッジごとのエラーの対応表を作成する。
    two_qubit_gate = next(
        name
        for name in target.operation_names
        if target[name]
        and all(q is not None and len(q) == 2 for q in target[name])
    )
    edge_error = {
        frozenset(qargs): (
            1.0 if props is None or props.error is None else props.error
        )
        for qargs, props in target[two_qubit_gate].items()
    }

    graph = backend.coupling_map.graph.to_undirected(multigraph=False)
    neighbors = {n: list(graph.neighbors(n)) for n in graph.node_indices()}

    def first_chain_from(start):
        path, visited = [start], {start}

        def grow():
            if len(path) == length:
                return True
            node = path[-1]
            order = sorted(
                neighbors[node],
                key=lambda m: edge_error.get(frozenset((node, m)), 1.0),
            )
            for nxt in order:
                if nxt not in visited:
                    visited.add(nxt)
                    path.append(nxt)
                    if grow():
                        return True
                    path.pop()
                    visited.remove(nxt)
            return False

        return path if grow() else None

    def chain_cost(path):
        return sum(
            edge_error.get(frozenset((path[i], path[i + 1])), 1.0)
            for i in range(len(path) - 1)
        )

    # 次数の小さい量子ビット(長い鎖の自然な端点)から試し、
    # 見つかった中で最もエラーの小さい鎖を残す。
    best_path, best_cost = None, float("inf")
    for start in sorted(neighbors, key=lambda n: len(neighbors[n])):
        chain = first_chain_from(start)
        if chain is not None and (cost := chain_cost(chain)) < best_cost:
            best_path, best_cost = chain, cost

    if best_path is None:
        raise ValueError(
            f"Could not find a connected chain of {length} qubits "
            f"on '{backend.name}'."
        )
    return best_path
小規模なシミュレーターでの例#
PNA は、特定の量子プロセッサーの 物理的な 2 量子ビット・ゲートのノイズを緩和します。このワークフローは、理想的なシミュレーターでは意味のある対応物がない、次の 2 つのハードウェア・サービスに依存しています。
NoiseLearnerV3は、トランスパイル済み回路の固有の 2 量子ビット層それぞれに付随するスパース・パウリ・リンドブラッド・ノイズチャネルを、実験的に特性評価します。ノイズのないシミュレーターでは学習すべきノイズが存在せず、伝播させる逆チャネルは恒等写像になってしまいます。Executorプリミティブは、samplomaticによって生成された、ツワーリングされランダム化された回路をバックエンド上でサンプリングします。
原理的には、人工的なノイズモデルで代用することもできます。たとえば、Qiskit Aer で PauliLindbladError 命令を付加し、得られたノイズを含む回路を generate_noise_mitigating_observable に直接渡すことができます。しかし、これは自分で注入したノイズに対して古典的な処理が正しいことを確認するだけであり、この手法の要点が分かりにくくなってしまいます。そのため、シミュレーターでの例は省略し、PNA のワークフロー全体をハードウェア上で直接示します。以下では、Qiskit パターンの各ステップを順に説明します。
大規模なハードウェアでの例#
ここからは、Qiskit パターンの 4 つのステップに従い、IBM Quantum® ハードウェア上で実行する 30 サイトのキックド・イジング・モデルに対して、PNA のワークフロー全体を実行します。
ステップ 1: 量子問題へマッピングする#
ミラーリングしたトロッター回路と観測量を生成する
この実験では、1 次元スピン鎖上の 30 サイトのキックド・イジング・モデルの時間ダイナミクスを調べます。考えるハミルトニアンは次のとおりです。
\(H = -J\sum\limits_{\langle i,j \rangle} Z_iZ_j + h\sum\limits_iX_i\),
ここで、\(J>0\) は最近接スピン間の結合(\(i<j\))を表し、全体にかかる横磁場 \(h\) は \(\frac{\pi}{8}\) に設定します。\(h\) がクリフォード角(つまり \(\theta=n\frac{\pi}{2}, n \in \mathbb{Z}\))から離れるほど、アンチノイズの生成子を回路全体に伝播させるのが難しくなります。
観測量としては、1 サイトあたりの平均磁化 \(\frac{1}{N} \sum_{i=1}^{N} \langle z_i \rangle\) を考えます。ここで \(N\) はサイト数です。
num_qubits = 30
num_trotter_steps = 10
rx_angle = np.pi / 8

# 1 サイトあたりの平均磁化
id_pauli = Pauli("I" * num_qubits)
observable = (
    SparsePauliOp([id_pauli.dot(Pauli("Z"), [i]) for i in range(num_qubits)])
    / num_qubits
)

# トロッター化したキックド・イジング・モデルを実装する
circuit = QuantumCircuit(num_qubits)
for _step in range(num_trotter_steps):
    circuit.rx(rx_angle, range(num_qubits))
    for first_qubit in (1, 2):
        for idx in range(first_qubit, num_qubits, 2):
            # Rzz(-pi/2) と等価:
            circuit.sdg([idx - 1, idx])
            circuit.cz(idx - 1, idx)
# 逆回路を追加してミラーリングを完成させる
circuit.compose(circuit.inverse(), inplace=True)
circuit.measure_active()
circuit.draw("mpl", fold=-1)
<Image src="/docs/images/tutorials/propagated-noise-absorption/extracted-outputs/8fcb5af8-64f0-498a-821f-11bcd7aea203-0.avif" alt="Output of the previous code cell" />
ステップ 2: ハードウェアでの実行に向けて問題を最適化する#
次のステップでは、ミラーリングしたトロッター回路を、実際の IBM Quantum ハードウェアで実行できるように準備します。QPU で実行するには、抽象的な回路を構成するだけでは不十分で、次の条件を満たすように最適化する必要があります。
バックエンドのネイティブなゲートセットと接続性に従っていること。 トランスパイルによって、論理回路は対象のバックエンドがサポートする ISA 回路にマッピングされます。これにより、すべてのゲートと量子ビット間の相互作用が物理的に実現可能になります。
回路の層の単位でノイズを特性評価できること。 PNA は、逆ノイズチャネルの学習と伝播に依存しています。これを効率よく行うために、トランスパイル済み回路を、固有の 2 量子ビットの「ボックス化された」層に分割します。これらのボックスによって、回路の各層をそれぞれの学習済みノイズモデルに対応付けることができます。
現実的なノイズモデルを PNA に渡せること。 回路をボックス化したら、
NoiseLearnerV3サービスを使って、固有の各 2 量子ビット層に影響するパウリ・ノイズチャネルを実験的に学習します。学習したモデルは、Samplomatic のアノテーションを通じて回路に結び付けられます。
全体として、このステップは、理想化されたミラー回路と、学習済みノイズモデルを備えたハードウェアで実行可能な回路との橋渡しをします。この準備によって、PNA は逆ノイズチャネルを回路全体に伝播させ、それに応じて観測量を調整できるようになります。
バックエンドに接続し、ISA 回路にトランスパイルする#
まず、IBM Quantum Compute Service を初期化し、バックエンドを選択します。認証情報を保存する手順 に従って自分のアカウントで認証しておくと、QiskitRuntimeService() が自動的にその認証情報を読み込みます。
# 保存した認証情報を使って IBM Quantum Compute Service を初期化する
service = QiskitRuntimeService()

backend = service.least_busy(
    operational=True, simulator=False, min_num_qubits=num_qubits
)
# 分数ゲートを有効にして再取得する(least_busy はこの設定を引き継がない)
# 非クリフォードの Rx 回転をネイティブにサポートするため、分数ゲートを有効にする。
backend = service.backend(backend.name, use_fractional_gates=True)
print(f"選択したバックエンド: {backend.name}")
Selected backend: ibm_fez
次に、バックエンド上で連結した量子ビットの鎖を選び、その上に回路をトランスパイルします。
セットアップのセクションで定義した find_qubit_chain ヘルパーを使って、num_qubits 個の連結した物理量子ビットからなる直線を選択します。次に、optimization_level=0 でトランスパイルし、この鎖を initial_layout として固定します。これにより、ミラー回路の 2 量子ビット・ゲートの層構造が正確に保たれます。この構造はボックス化とノイズ学習のステップの前提となるため、ここでは(ミラーリングしたゲートを打ち消してしまう)より高い最適化レベルは避ける必要があります。
# 選択したバックエンド上で、エラーの小さい連結した量子ビットの鎖を見つける
layout = find_qubit_chain(backend, num_qubits)

# 鎖をレイアウトとして固定し、対象のバックエンド向けに回路をトランスパイルする。
# optimization_level=0 にすると、ボックス化とノイズ学習のステップの前提となる
# ミラーリングした 2 量子ビット・ゲートの層が保たれる。
pm = generate_preset_pass_manager(
    backend=backend, optimization_level=0, initial_layout=layout
)
isa_circuit = pm.run(circuit)
isa_observable = observable.apply_layout(isa_circuit.layout)
isa_circuit.draw("mpl", fold=-1)
<Image src="/docs/images/tutorials/propagated-noise-absorption/extracted-outputs/8c9afe5e-6fa3-427d-a672-becdb14490b8-0.avif" alt="Output of the previous code cell" />
2 量子ビット・ゲートの層と測定をツワーリングし、固有の層を見つける#
samplomatic を使って回路をボックス化し、固有の 2 量子ビット層を特定します。ボックスとは、命令をまとめてグループ化する構成要素で、後から特定の意図やアノテーションを同じボックス内のすべてのゲートに一様に適用できるようにするものです。
ここでは generate_boxing_pass_manager メソッドを呼び出します。このメソッドは、2 量子ビット層を特定するだけでなく、いくつかの重要な処理を行います。
回路内のすべての 2 量子ビット層をグループ化する。
それらの層に
TwirlとChangeBasisのアノテーションを適用する。測定操作を、それぞれ独自のボックス化されたセクションにグループ化する。
各 2 量子ビット層に
InjectNoiseアノテーションを適用する。
これらのアノテーションは、回路全体でノイズ、基底変換、ツワーリングをどのように扱うかを定義します。また、後でノイズを学習・緩和するときに使う構造も確立します。
主な設定オプションは次のとおりです。
enable_gates/enable_measures: True: すべての 2 量子ビット・ゲートの層と終端の測定をボックス化します。1 量子ビット・ゲートは、ボックス内で左側のドレス(left-dressed)として扱われます。measure_annotations: all: 測定ボックスにTwirlとChangeBasisのアノテーションを含めます。twirling_strategy: active: エンタングリング・ゲートを含む各ボックスで、アクティブなすべての量子ビットをツワーリングします。inject_noise_targets: gates: エンタングリング・ゲートを含み、Twirlアノテーションが付いたすべてのボックスにInjectNoiseアノテーションを追加します。inject_noise_strategy: uniform_modification: 回路全体で、すべてのノイズ層を同じようにスケーリングします。
# Twirl と InjectNoise のアノテーションを付けて回路をボックス化する
pm = generate_boxing_pass_manager(
    enable_gates=True,
    enable_measures=True,
    measure_annotations="all",
    twirling_strategy="active",
    inject_noise_targets="gates",
    inject_noise_strategy="uniform_modification",
)
boxed_circuit = pm.run(isa_circuit)
draw_circ = QuantumCircuit(boxed_circuit.num_qubits)
draw_circ.append(boxed_circuit.data[0], qargs=boxed_circuit.data[0].qubits)
draw_circ.append(boxed_circuit.data[1], qargs=boxed_circuit.data[1].qubits)
draw_circ.draw("mpl", fold=-1, scale=0.3, idle_wires=False)
<Image src="/docs/images/tutorials/propagated-noise-absorption/extracted-outputs/9c911a29-553c-4ffe-94de-1442f25e3116-0.avif" alt="Output of the previous code cell" />
回路をどのようにサンプリングするかを定義する、テンプレート回路と samplex を生成します。
ここでは、スペクテーター測定とポストセレクション用の測定も追加します。これらは、Executor から出力されるサンプルに対してポストセレクションを行うために必要です。
# 後で "Executor" で使うテンプレート回路と samplex を構築する
template_circuit, samplex = samplomatic.build(boxed_circuit)

# テンプレート回路にポストセレクション用の命令を追加する
post_selection_pm = PassManager(
    [
        AddSpectatorMeasures(backend.coupling_map),
        AddPostSelectionMeasures(x_pulse_type="rx"),
    ]
)
template_circuit = post_selection_pm.run(template_circuit)
draw_circ = template_circuit.copy_empty_like()
draw_circ.data = template_circuit.data[:324]
draw_circ.draw("mpl", fold=-1, scale=0.3, idle_wires=False)
<Image src="/docs/images/tutorials/propagated-noise-absorption/extracted-outputs/8d46f7b1-f0e9-4bc3-ba0f-5cc96090a945-0.avif" alt="Output of the previous code cell" />
NoiseLearnerV3 を使ってノイズを学習する#
PNA をエラー緩和に適用する前に、まず回路内の固有の各 2 量子ビット層と測定層に作用するノイズを特性評価する必要があります。そのために、NoiseLearnerV3 プログラムを使い、先ほど特定した各層のノイズモデルを実験的に学習します。学習器は、各層に影響するノイズチャネルを推定するベンチマーク形式の実験を行い、学習したモデルを含む結果オブジェクトを返します。
まず、samplomatic の find_unique_box_instructions を使って、回路内の固有の層を特定します。これにより、異なる種類の層ごとに 1 回だけノイズを学習すればよくなり、実験の回数と全体のショット・コストを最小限に抑えられます。得られた層のリストを、ノイズ学習器に渡します。
ノイズの学習方法を制御する主なパラメーターは次のとおりです。
num_randomizations: 学習の設定ごとに使うランダム回路の数。shots_per_randomization: 学習用のランダム回路ごとのショット数。layer_pair_depths: 学習実験で使う回路の深さ(層のペアの数で測る)。post_selection:rxゲートを使って測定後のパルスを適用する、エッジ・ベースのポストセレクションを有効にします。
# ノイズ学習のパラメーター
num_randomizations_nl = 64
shots_per_randomization_nl = 128

# ノイズ学習の最大の深さを、緩和する回路の深さに合わせる。
# ``layer_pair_depths`` は層のペア(層とその逆)の数で測るため、最大値は
# 回路の 2 量子ビット層の深さの半分になる。
# この深さまで学習すると、緩和の品質が向上する。

depth_2q = isa_circuit.depth(lambda instr: instr.operation.num_qubits == 2)
max_layer_pair_depth = depth_2q // 2

# 学習する深さは固定のスケジュールを使うが、回路の深さを超えるものは除外し、
# 最大値を常に ``max_layer_pair_depth`` で打ち切ることで、緩和する回路より
# 深く学習しないようにする
candidate_depths = [1, 2, 4, 8, 12, 16, 24, 32, 40, 48]
layer_pair_depths = sorted(
    {d for d in candidate_depths if d < max_layer_pair_depth}
    | {max_layer_pair_depth}
)

# ボックス化した回路から固有の命令(層)を見つける
unique_2q_layers_and_meas = find_unique_box_instructions(
    boxed_circuit, normalize_annotations=None, undress_boxes=True
)

# 固有の層に対してノイズ学習器を設定して実行する。
# オプションは辞書として直接渡せる。
noise_learner_options = {
    "num_randomizations": num_randomizations_nl,
    "shots_per_randomization": shots_per_randomization_nl,
    "layer_pair_depths": layer_pair_depths,
    "post_selection": {
        "enable": True,
        "strategy": "edge",
        "x_pulse_type": "rx",
    },
    "environment": {"job_tags": ["TUT_PNA"]},
}

noise_learner = NoiseLearnerV3(backend, noise_learner_options)
noise_learner_job = noise_learner.run(unique_2q_layers_and_meas)
noise_learner_result = noise_learner_job.result()
学習したノイズ・レートを可視化する#
ノイズモデルを学習したら、1 量子ビット演算と 2 量子ビット演算の両方について、推定されたエラー・レートの分布を確認できます。次のコードは、学習したノイズの結果からパウリ・リンドブラッド表現を取り出し、対応するノイズ・レートを集めます。
学習した各層について、次の処理を行います。
ノイズモデルを
(pstr, qubits, rate)のタプルのスパースなリストに変換します。ここでpstrは指定した量子ビットに作用するパウリ文字列、rateはそれに対応するエラー・レートです。レートを 1 量子ビット(
len(pstr) == 1)の項と 2 量子ビット(len(pstr) == 2)の項に分けます。それぞれのレートのリストを並べ替え、中央値を計算します。
学習したパウリ・リンドブラッド生成子の相対的な大きさを比較できるように、1 量子ビット(赤)と 2 量子ビット(青)のノイズ・レートの分布を対数スケールでプロットし、中央値を縦線で示します。1 量子ビットと 2 量子ビットのレートの大小関係は、デバイスや特性評価する層によって異なります。今回の実行では、1 量子ビット(重み 1)の生成子のほうが中央値のレートが大きくなっています。
hw_rates_1q = []
hw_rates_2q = []
for nlr in noise_learner_result[:2]:
    plm_list = nlr.to_pauli_lindblad_map().to_sparse_list()
    hw_rates_1q += [
        rate for (pstr, qubits, rate) in plm_list if len(pstr) == 1
    ]
    hw_rates_2q += [
        rate for (pstr, qubits, rate) in plm_list if len(pstr) == 2
    ]
hw_rates_1q = sorted(hw_rates_1q)
hw_rates_2q = sorted(hw_rates_2q)
median_1q = hw_rates_1q[len(hw_rates_1q) // 2]
median_2q = hw_rates_2q[len(hw_rates_2q) // 2]
fig, ax = plt.subplots(1, 1, figsize=(14, 5))
ax.scatter(
    (hw_rates_1q),
    [(i) / (len(hw_rates_1q) - 1) for i in range(len(hw_rates_1q))],
    color="red",
    label="1q rates",
)
ax.set_xscale("log")
ax.set_ylim(0, 1.1)
ax.vlines(median_1q, 0, 1, color="red")
ax.text(median_1q * 1.1, 0.1, f"{median_1q:.2e}")
ax.scatter(
    (hw_rates_2q),
    [(i) / (len(hw_rates_2q) - 1) for i in range(len(hw_rates_2q))],
    color="blue",
    label="2q rates",
)
ax.set_xscale("log")
ax.set_ylim(0, 1.1)
ax.vlines(median_2q, 0, 1, color="blue")
ax.text(median_2q * 1.1, 0.2, f"{median_2q:.2e}")
ax.set_title("Learned noise rates")
ax.set_xlabel("Noise rate")
ax.set_yticks([])
plt.legend()
<matplotlib.legend.Legend at 0x125336120>
<Image src="/docs/images/tutorials/propagated-noise-absorption/extracted-outputs/b1a8ad48-2875-41e0-92c4-c28b34083e6b-1.avif" alt="Output of the previous code cell" />
回路のボックスを学習済みノイズに対応付ける#
固有の各 2 量子ビット層のノイズモデルが得られたら、それらを、ボックス化した回路内の対応する InjectNoise アノテーションに結び付ける必要があります。
InjectNoise ディレクティブは samplomatic のアノテーションの 1 つで、1 量子ビットのドレッサーを使って、制御された設定可能な方法で回路にノイズを注入します。これにより、異なる層にまたがるモジュール化されたノイズ・モデリングが可能になります。
各 InjectNoise アノテーションには、次のものが含まれます。
InjectNoise.ref- アノテーションの一意な識別子。samplexオブジェクトが、対応するノイズモデルを正しく割り当てるために使います。InjectNoise.modifier_ref(任意) - 割り当てたノイズモデルを乗数でスケーリングできるようにする、補助的な参照。
このステップでは、各 InjectNoise.ref から、対応する学習済みノイズモデル(PauliLindbladMap)への対応表を作成します。この対応表によって、回路内のエンタングリング・ゲートの各層が適切なノイズモデルと対になり、サンプリングとその後のノイズ緩和のステップでノイズの影響が正確に適用されるようになります。
# InjectNoise の ref をパウリ・リンドブラッド写像に対応付ける
refs_to_noise_models = {}
for instruction, result in zip(
    unique_2q_layers_and_meas, noise_learner_result, strict=False
):
    if inject_noise_annot := get_annotation(
        instruction.operation, InjectNoise
    ):
        refs_to_noise_models[inject_noise_annot.ref] = (
            result.to_pauli_lindblad_map()
        )
学習したアンチノイズを通して観測量を伝播させる#
前述のとおり、これは 2 つのステップで行います。まず、アンチノイズの生成子を回路の末尾まで伝播させます。その後、発展させたその生成子を通して観測量を伝播させます。このプロセスを、回路内のアンチノイズの生成子ごとに繰り返します。この実装では、ある層に含まれる各生成子は、並列に回路の末尾まで伝播されます。さらに、Python のマルチプロセッシングを使って、アンチノイズの前方伝播と観測量の逆伝播の両方を並列に実行します。これにより、発展させた生成子がメモリー上に溜まるのを防ぐとともに、計算資源を最大限に活用できます。
PNA を実行するときは、ノイズを含む回路と観測量を必ず指定する必要があります。ノイズを含む回路が InjectNoise アノテーション付きのボックス化された回路である場合は、前のステップで作成した対応表も指定する必要があります。qiskit-aer の PauliLindbladError 命令を含む、ボックス化されていない回路を渡すこともできます。その場合、refs_to_noise_models を指定する必要はありません。主な入力に加えて、次の点も考慮してください。
max_err_terms: 各アンチノイズの生成子を前方伝播させる際に保持する項の数。この値を大きくすると一般に精度は向上しますが、その振る舞いが単調である保証はありません。max_obs_terms: ノイズを緩和する観測量 \(\tilde{O}\) を、発展させたアンチノイズを通して逆伝播させる際に保持する項の数。値を大きくすると一般に精度は向上しますが、単調に向上する保証はありません。num_processes: このプロセスに割り当てるコアの数。生成子は並列に前方伝播され、観測量に適用されることを思い出してください。search_step: 逆伝播のステップでは、パウリ基底で 2 つの演算子を近似的に共役させるために貪欲法を使います。search_stepを大きくすると、この方法を高速化できます。詳しくは、pauli-propのドキュメント を参照してください。num_to_measure: この変数はgenerate_noise_mitigating_observableへの入力ではありませんが、\(\tilde{O}\) のうち実際に測定する項の数を制御するために使います。ここでは上位 30 項のみを測定します。これらは元の観測量に含まれていた項です。これらの項は、測定すると学習したゲート・ノイズが緩和されるように、リスケーリングされています。\(\tilde{O}\) から測定するのは 30 項だけですが、\(\tilde{O}\) を大きく成長させておくと、主要な項のスケーリング係数の精度が上がるため、多くの場合に有用です。
# PNA のパラメーター
num_processes = 8
max_err_terms = 10_000
max_obs_terms = 10_000
num_to_measure = num_qubits

obs_tilde_isa = generate_noise_mitigating_observable(
    boxed_circuit,
    isa_observable,
    refs_to_noise_models,
    max_err_terms=max_err_terms,
    max_obs_terms=max_obs_terms,
    num_processes=num_processes,
    print_progress=True,
    search_step=8,
)
p_2_v = {p: v for v, p in enumerate(layout)}
obs_tilde_virtual = SparsePauliOp.from_sparse_list(
    [
        (pstr, [p_2_v[p] for p in p_qubits], coeff)
        for (pstr, p_qubits, coeff) in obs_tilde_isa.to_sparse_list()
    ],
    num_qubits=num_qubits,
)
obs_tilde_virtual = obs_tilde_virtual[
    np.argsort(np.abs(obs_tilde_virtual.coeffs))[::-1]
][:num_to_measure]
Finished! 13740 / 13740 generators propagated.
obs_tilde_isa = obs_tilde_isa[np.argsort(np.abs(obs_tilde_isa.coeffs))][::-1]
plt.xscale("log")
plt.yscale("log")
plt.title(r"$\tilde{O}$ coeff magnitudes")
plt.ylabel("Magnitude")
plt.xlabel("Pauli term index")
plt.plot(np.abs(obs_tilde_isa.coeffs), ".")
[<matplotlib.lines.Line2D at 0x124b0a120>]
<Image src="/docs/images/tutorials/propagated-noise-absorption/extracted-outputs/77246aef-1892-4a27-bbf0-128b12206581-1.avif" alt="Output of the previous code cell" />
測定基底を標準形に変換する#
次に、測定する観測量のすべてのパウリ項を完全にカバーできる、最小の測定基底の集合を見つけます(量子ビットごとに可換であれば、多くの観測量を同時に測定できます)。ここでは元の観測量、つまり単一の Z からなるパウリ演算子の総和に含まれる項のみを測定するので、必要な基底は全 Z 基底の 1 つだけです。
パウリ測定基底の集合を見つけることに加えて、これらのパウリ項を、Executor が想定する標準形に対応付ける必要があります。量子ビットの標準的な順序について詳しくは、Samplomatic のドキュメント を参照してください。
meas_box = boxed_circuit.data[-1]
canonical_qubits = [
    idx
    for idx, qubit in enumerate(boxed_circuit.qubits)
    if qubit in meas_box.qubits
]
c_2_p = {
    c: p for c, p in enumerate(canonical_qubits)
}  # 標準形 -> 物理
p_2_v = {p: v for v, p in enumerate(layout)}  # 物理 -> 仮想
c_2_v = {c: p_2_v[p] for c, p in c_2_p.items()}  # 標準形 -> 仮想
meas_bases, bases_reverser = get_measurement_bases(obs_tilde_virtual)
meas_bases_canonical = [
    np.array([base[c_2_v[c]] for c in range(num_qubits)], dtype=np.uint8)
    for base in meas_bases
]
ステップ 3: 量子実験を実行する#
QuantumProgram でサンプリング方法を指定する#
ここで、QuantumProgram を設定します。これは、Executor によって実行されるすべての回路とサンプリング設定をまとめる中心的なコンテナーです。このオブジェクトは、PNA で使う測定結果を得るために、ランダム化した回路インスタンスをどのように生成し、まとめ、実行するかを定義します。
QuantumProgram には複数の項目を含めることができ、各項目はテンプレート回路と、ランダム化の適用方法を定義する対応する samplex オブジェクトで構成されます。この抽象化によって、Executor は、ランダム化した回路の生成からショットの収集・集約までのワークフロー全体を、1 つのモジュール化されたプログラムとして扱えるようになります。
このステップでは、先ほど構築したテンプレート回路と samplex を使って PNA の実験を実行する QuantumProgram を作成します。設定には次の要素が含まれます。
template_circuit: 必要なすべてのランダム化(ツワーリングのランダム化やパラメーターなど)を実装するのに必要な、すべてのゲートを含む回路。samplex: 可能なすべての回路のランダム化にわたる確率分布を定義するオブジェクトで、そこからサンプリングを行います。samplex_arguments:samplexを完全に定義するために必要なバインディングbasis_changes: 測定する観測量のすべてのパウリ項をカバーする、測定基底の集合をここで指定します。noise_scales.ref: サンプルに追加のノイズが注入されないように、各ノイズ層のスケールを0.0に設定します。pauli_lindblad_maps:noise_scalesを渡す場合に必要です。ノイズ層を、対応するノイズモデルに対応付けるだけのものです。
shape:samplex_argumentsによって暗黙的に定義される形状を拡張するための、形状のタプル。この拡張によって導入される自明でない軸が、ランダム化を列挙します。
# 実行時のショット数を制御する
shots_per_randomization_exec = 64
num_randomizations_exec = 6144

# 実行中にノイズが注入されないように、ノイズをゼロにする。
# InjectNoise アノテーションを追加したのは、PNA がノイズを回路内の層に
# 対応付けられるようにするためだけである
samplex_inputs = {f"noise_scales.{ref}": 0.0 for ref in refs_to_noise_models}
samplex_inputs |= {"pauli_lindblad_maps": refs_to_noise_models}

# 測定する基底を指定する。samplex は ChangeBasis アノテーションの付いたボックスごとに
# 基底変換の入力を 1 つ公開する。ここでは全 Z 基底 1 つですべての項をカバーできる。
# 基底変換のインターフェース名は回路のボックス構造に依存するため、インデックスを
# ハードコードせずに名前を検索する。
bases_broadcastable = np.expand_dims(np.array(meas_bases_canonical), axis=1)
samplex_inputs |= {
    spec.name: bases_broadcastable
    for spec in samplex.inputs().get_specs(r"^basis_changes\.")
}

# QuantumProgram に渡すために samplex_inputs を辞書に変換する
samplex_arguments = (
    samplex.inputs().make_broadcastable().bind(**samplex_inputs)
)

# 指定したパラメーターで QuantumProgram をインスタンス化する
program = QuantumProgram(shots=shots_per_randomization_exec)
program.append_samplex_item(
    circuit=template_circuit,
    samplex=samplex,
    samplex_arguments=samplex_arguments,
    shape=(num_randomizations_exec,),
)
Executor を使って回路をサンプリングする#
QuantumProgram を定義したので、実験の実行は簡単です。Executor オブジェクトをインスタンス化してバックエンドを渡し、プログラムを実行するだけです。
# 回路を実行(サンプリング)する
executor = Executor(backend)
job_exec = executor.run(program)
exec_results = job_exec.result()
ステップ 4: 結果を再構成して分析する#
エラーを緩和した期待値を計算するために、次の処理を行います。
測定に影響する学習済みノイズに基づいて、TREX のスケーリング係数を計算する。
ポストセレクションで残ったサンプルだけを保持するためのマスクを生成する。
qiskit-addon-utilsのexecutor_expectation_values関数を使って、すべてのデータを組み合わせ、エラーを緩和した期待値を求める。
# TREX の係数を計算する
measurement_noise_map = noise_learner_result[2].to_pauli_lindblad_map()
trex_rescale_factors = trex_factors(measurement_noise_map, bases_reverser)

# 結果をポストセレクションする
post_selector = PostSelector.from_circuit(
    circuit=template_circuit, coupling_map=backend.coupling_map
)

# 結果を絞り込むためのポストセレクションのマスクを計算する
mask = post_selector.compute_mask(exec_results[0], strategy="edge")

# ポストセレクションした結果を使って期待値を計算する
results = executor_expectation_values(
    exec_results[0]["meas"],
    bases_reverser,
    meas_basis_axis=0,
    avg_axis=1,
    measurement_flips=exec_results[0]["measurement_flips.meas"],
    pauli_signs=exec_results[0].get("pauli_signs", None),
    postselect_mask=mask,
    rescale_factors=trex_rescale_factors,
)
緩和戦略の比較: PNA、PNA+TREX、PNA+PS、PNA+PS+TREX#
Executor の結果を使って、いくつかの緩和のバリエーションについて期待値を計算し、可視化します。
bases_reverser_unmit = {Pauli("Z" * num_qubits): [observable]}
args = [
    (bases_reverser_unmit, None, None),
    (bases_reverser, None, None),
    (bases_reverser, None, trex_rescale_factors),
    (bases_reverser, mask, None),
    (bases_reverser, mask, trex_rescale_factors),
]

evs = []
for reverser, postsel_mask, factors in args:
    # ポストセレクションした結果を使って期待値を計算する
    res_ps = executor_expectation_values(
        exec_results[0]["meas"],
        reverser,
        meas_basis_axis=0,
        avg_axis=1,
        measurement_flips=exec_results[0]["measurement_flips.meas"],
        pauli_signs=exec_results[0].get("pauli_signs", None),
        postselect_mask=postsel_mask,
        rescale_factors=factors,
    )
    res_ps = np.array(res_ps)
    evs.append(res_ps[:, 0][0])

experiments = ["PNA", "PNA+TREX", "PNA+PS", "PNA+PS+TREX"]
colors = ["#d9d9d9", "#b0b0b0", "#7f7f7f", "#4c4c4c"]
plt.bar(experiments, evs[1:], color=colors)
plt.axhline(y=1, color="green", linestyle="--", linewidth=2, label="Ideal")
plt.axhline(
    y=evs[0], color="red", linestyle="--", linewidth=2, label="Unmitigated"
)
plt.ylabel("Expectation value", fontsize=14)

plt.title(
    r"30q Mirrored Ising, 10 Trotter steps, $\theta_{rx}=\frac{\pi}{8}$",
    fontsize=14,
)
plt.legend(loc="upper left", bbox_to_anchor=(1.05, 1), borderaxespad=0.0)
plt.xticks(rotation=45)
plt.tight_layout()
plt.show()
<Image src="/docs/images/tutorials/propagated-noise-absorption/extracted-outputs/8df9366c-d456-416b-80ab-3b941a07a935-0.avif" alt="Output of the previous code cell" />
この結果は、異なるエラー緩和手法を組み合わせることによる累積的な効果を示しています。PNA 単独でも、期待値は理想的なベンチマークの値に近いところまで回復しています。これは、逆ノイズチャネルを観測量に伝播させることで、2 量子ビット・ゲートのエラーが効果的に補償されることを示しています。
TREX による再重み付けを追加する(PNA+TREX)と、ランダム化した回路におけるサンプリングの偏りが補正され、推定値がわずかに改善します。
ポストセレクション(PNA+PS)では、残留エラーに起因すると考えられる一貫性のない測定結果が除外されるため、より顕著な改善が得られます。
最後に、両方を組み合わせる(PNA+PS+TREX)と最も正確な結果が得られ、理想値にほぼ一致します。これは、これらの緩和戦略が互いに補強し合うことを示しています。
全体として、この比較から、PNA がノイズを考慮した期待値推定の堅牢な基盤となり、TREX とポストセレクションがさらなる精度向上のための補完的な改良を提供することが分かります。
次のステップ#
この内容に興味を持たれた方には、次の資料もお勧めします。
おすすめ
samplomaticとpauli-propのドキュメント
© IBM Corp., 2017-2026